

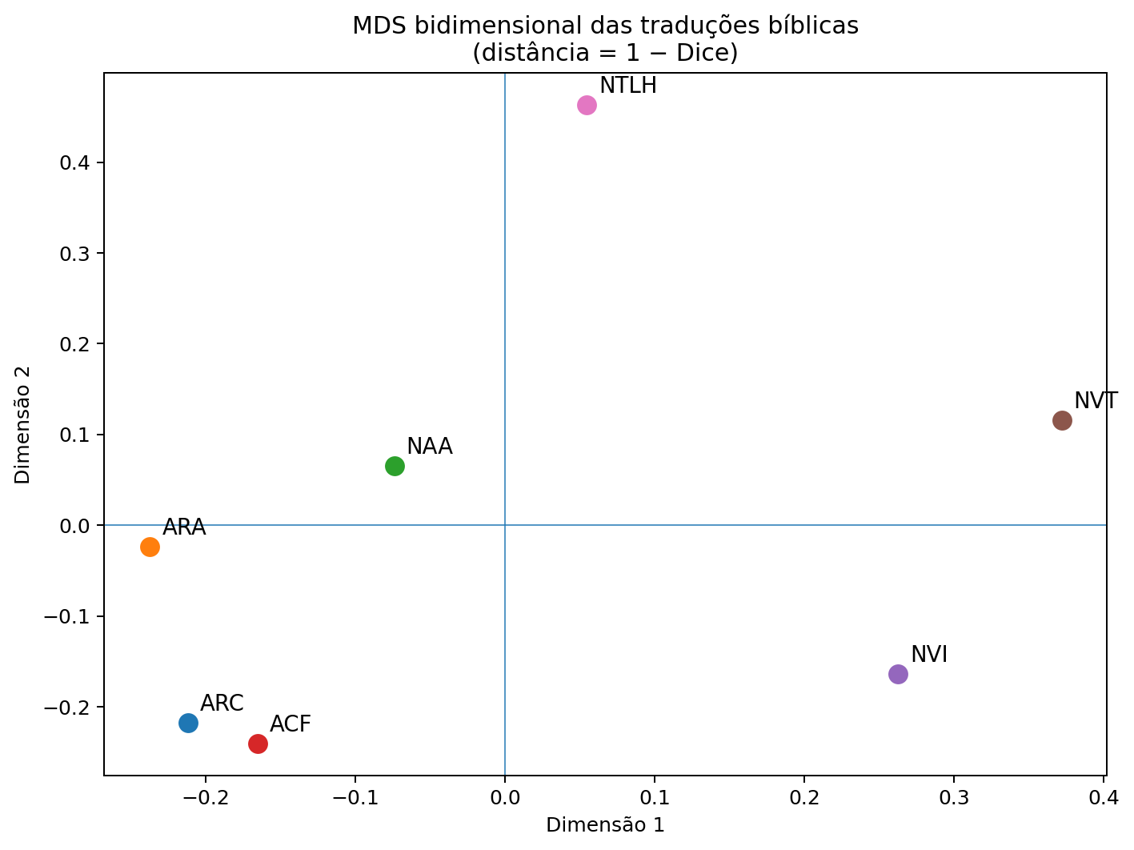
Diversas traduções da Bíblia em português, pertencentes a diferentes filosofias de tradução, são amplamente utilizadas no Brasil. Este estudo preliminar quantifica o grau de similaridade lexical entre sete versões: ARC, ARA, NAA, ACF, NVI, NVT e NTLH, utilizando o coeficiente de coincidência de Dice aplicado às palavras de cada versículo, após tokenização, remoção de pontuação e exclusão de stopwords em português. A matriz de similaridade resultante é analisada por Multidimensional Scaling (MDS) e agrupamento hierárquico aglomerativo, com linkage centróide.
Foram analisadas sete traduções com 66 livros canônicos protestantes em comum. A unidade textual básica foi o versículo. Para cada versão, os textos foram estruturados por livro, capítulo e versículo; em seguida, realizou-se a tokenização, a remoção de pontuação e a exclusão de palavras funcionais (stopwords) em português. O conjunto de palavras remanescente foi utilizado para calcular a coincidência lexical entre traduções correspondentes.
| Sigla | Nome completo aproximado | Filosofia principal |
| ARC | Almeida Revista e Corrigida | Formal / literal |
| ARA | Almeida Revista e Atualizada | Formal |
| NAA | Nova Almeida Atualizada | Formal; revisão recente |
| ACF | Almeida Corrigida Fiel | Formal / muito literal |
| NVI | Nova Versão Internacional | Equivalência dinâmica / intermediária |
| NVT | Nova Versão Transformadora | Dinâmica / contemporânea |
| NTLH | Nova Tradução na Linguagem de Hoje | Dinâmica / linguagem simples |
Para dois conjuntos de palavras A e B, o coeficiente de Dice é definido por:
Dice(A,B) = 2|A ∩ B| / (|A| + |B|)
O valor varia de 0 a 1: valores próximos de 1 indicam maior coincidência lexical, enquanto valores próximos de 0 indicam menor sobreposição. O estudo utiliza a média dos coeficientes calculados nos versículos correspondentes para obter uma medida global de similaridade entre cada par de traduções.
A distância utilizada nas análises multivariadas foi definida como d = 1 − Dice. Assim, quanto maior a similaridade lexical, menor a distância entre duas traduções.
O relatório comparativo anexado ao estudo brasileiro registra uma amostra de 1.014 respondentes e descreve forte presença da tradição Almeida, com 61,1% das respostas atribuídas a versões dessa família. O mesmo relatório registra preferência por formato impresso em 78,7% da amostra e posse de Bíblia de estudo em 77,2%.
A análise MDS apresentada neste novo relatório não mede preferência dos leitores. Ela analisa os próprios textos bíblicos e, portanto, complementa a pesquisa de percepção: enquanto o levantamento responde ‘quais versões os leitores utilizam e como percebem a Bíblia?’, a análise lexical responde ‘quão semelhantes são os textos dessas versões entre si?’.
Essa distinção permite integrar duas dimensões do estudo brasileiro: a dimensão sociológica da escolha das traduções e a dimensão textual da distância lexical. A coincidência entre forte presença da família Almeida na amostra de leitores e a elevada coesão lexical entre ARC, ACF, ARA e NAA constitui um achado descritivo interessante, mas não permite inferir causalidade entre preferência e similaridade lexical.

